PDFBookmarkGen
Erzeuge Lesezeichen aus dem Inhaltsverzeichnis – in langen PDFs nie wieder die Orientierung verlieren.
Importiere ein PDF: Ein KI-Bildmodell liest das Inhaltsverzeichnis automatisch, erkennt die Kapitelhierarchie und speichert klickbare, mehrstufige Lesezeichen in einer neuen Datei. Das Original bleibt unangetastet – nie wieder die Orientierung verlieren.
- KI-Lesen des Inhaltsverzeichnisses
- Mehrstufiger Lesezeichenbaum
- Original bleibt unverändert
- iPhone · iPad · Mac
Was es kann
PDFs mit Inhaltsverzeichnis, aber ohne Lesezeichen, bekommen einen echten klickbaren Umriss: lesen, strukturieren, schreiben.
Inhaltsverzeichnis-Erkennung
Findet die Inhaltsverzeichnis-Seiten in deinem PDF – ein KI-Bildmodell liest Titel und Seitenzahlen Zeile für Zeile.
Strukturierte Lesezeichen
Gängige Nummerierungen wie „Kapitel X“ oder „1.1.1“ werden automatisch als mehrstufiger Lesezeichenbaum wiederhergestellt.
Speichert eine Kopie
Lesezeichen landen in einer neu erzeugten Kopie – dein Original-PDF bleibt genau, wie es war.
Ein Kauf, alle Geräte
Eine Universal-App für iPhone, iPad und Mac – ein Kauf gilt überall.
Das Inhaltsverzeichnis lesen
Inhaltsverzeichnisse sind gewöhnlicher Text in wild verschiedenen Layouts – deshalb liest sie ein KI-Bildmodell Zeile für Zeile, statt auf glückliche starre Regeln zu setzen.
Inhaltsseiten automatisch gefunden
Nach dem Import werden die Inhaltsverzeichnis-Seiten automatisch erkannt – kein manuelles Markieren.
KI-Bilderkennung
Das Bildmodell liest das Inhaltsverzeichnis als Bild und entnimmt Titel und Seitenzahlen aus jedem Layout.
Menschliche Bestätigung
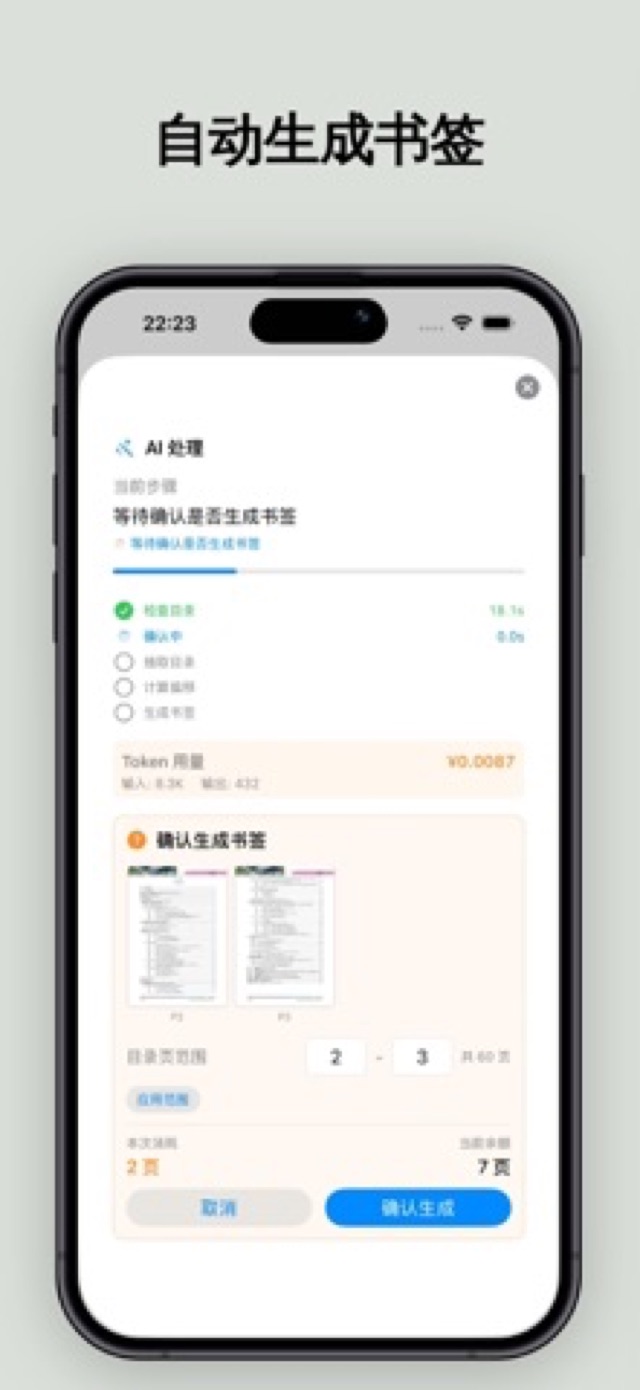
Die Ergebnisse erscheinen zuerst zur Bestätigung – Titel, Ebene oder Seitenzahlen lassen sich einzeln korrigieren, bevor es weitergeht.
Den Lesezeichenbaum aufbauen
Aus Zeilen für Zeile Inhaltsverzeichnis wird ein klar gegliederter Kapitelbaum – die Nummerierung entscheidet alles.
Vielfältige Nummerierungen
Unterstützt gängige Stile wie „Kapitel X / Abschnitt X“, „(一)(二)“ oder „1.1.1“.
Dual-Regex + Stack
Zwei Regex-Durchgänge prüfen sich gegenseitig, während ein Stack-Algorithmus die Tiefe bestimmt und die Struktur originalgetreu wiederherstellt.
Berechnung des Seitenversatzes
Inhaltsverzeichnis- und PDF-Seitennummern weichen oft ab – der Versatz wird automatisch berechnet, damit jedes Lesezeichen exakt springt.
Generieren & Exportieren
Das Ergebnis ist ein Standard-PDF-Umriss – direkt anklickbar in der Seitenleiste auf iPhone, iPad und Mac.
Natives PDF-Outline
Über PDFKit als standardmäßige, rekursive Outline geschrieben – System- und Drittanbieter-Reader verstehen sie gleichermaßen.
Original bleibt erhalten
Lesezeichen landen in einer neu gespeicherten Kopie – das Original bleibt unberührt.
Mehrere Dateien in Warteschlange
Gib einen ganzen Stapel PDFs ab – sie werden einer nach dem anderen verarbeitet, lange Paper oder eine komplette E-Book-Sammlung.
Galerie
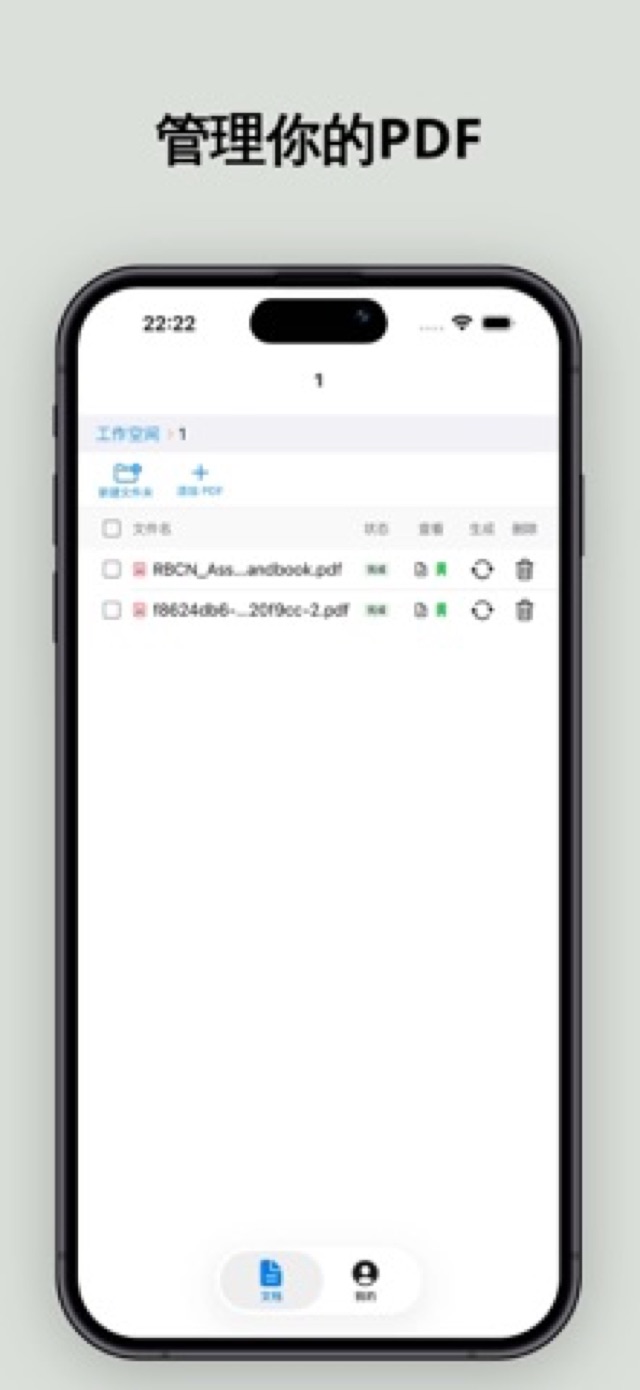
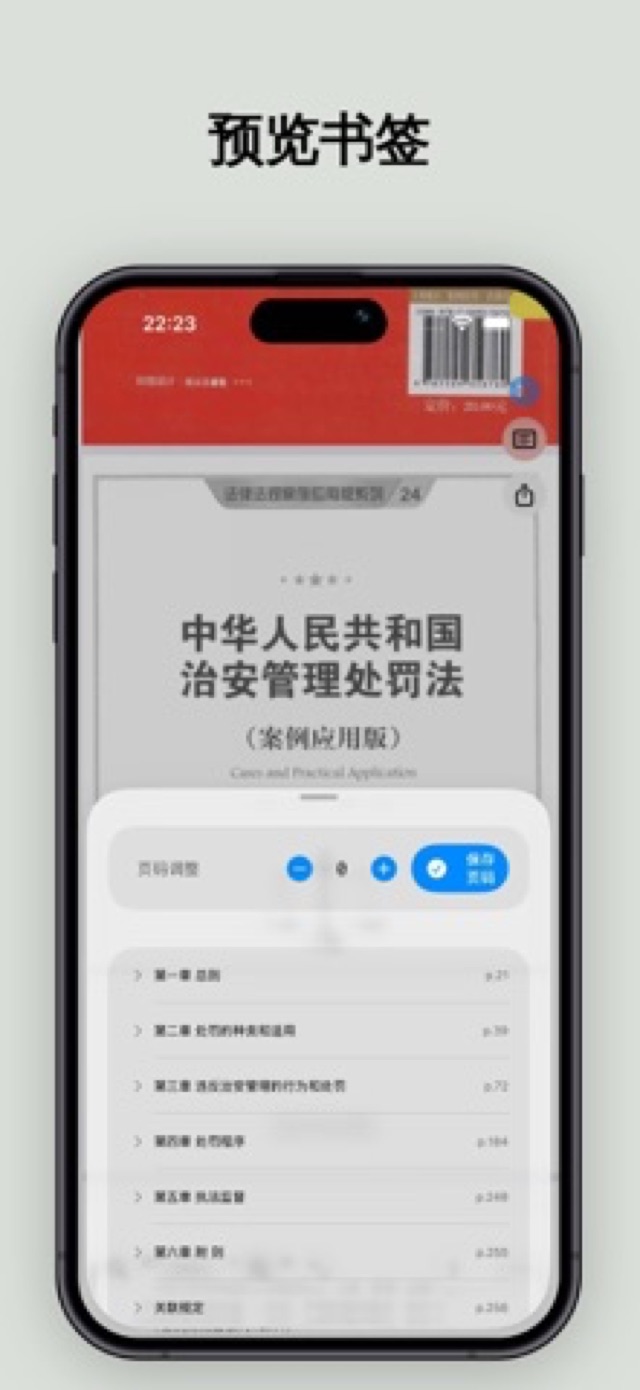
Vom PDF-Import bis zum Sprung per Lesezeichen – ein Blick in die echte App.
Häufige Fragen
Was kostet die App?
Ein Guthabensystem nach Anzahl der analysierten Seiten: Du siehst die Kosten vorab, kaufst Credits nach Bedarf – ein Abo ist nie nötig.
Welche Geräte werden unterstützt?
Eine Universal-App für iPhone, iPad und Mac, erfordert iOS / iPadOS 16+ oder macOS 13+; ein Kauf gilt für alle drei.
Wird meine Originaldatei verändert?
Nie. Lesezeichen werden in eine neu erzeugte Kopie geschrieben – das Original-PDF bleibt exakt, wie es war.
Was, wenn die Erkennung ungenau ist?
Vor der Generierung gibt es einen Bestätigungsschritt: Titel, Ebene oder Seitennummer lassen sich manuell korrigieren – geschrieben wird erst nach deiner Freigabe.
In langen PDFs nie wieder den Faden verlieren
Importieren, bestätigen, generieren — gib jedem PDF ein klickbares Inhaltsverzeichnis.