AI Neural
Mit anschaulichen Interaktionen und Visualisierungen sanft in die Welt der KI eintauchen.
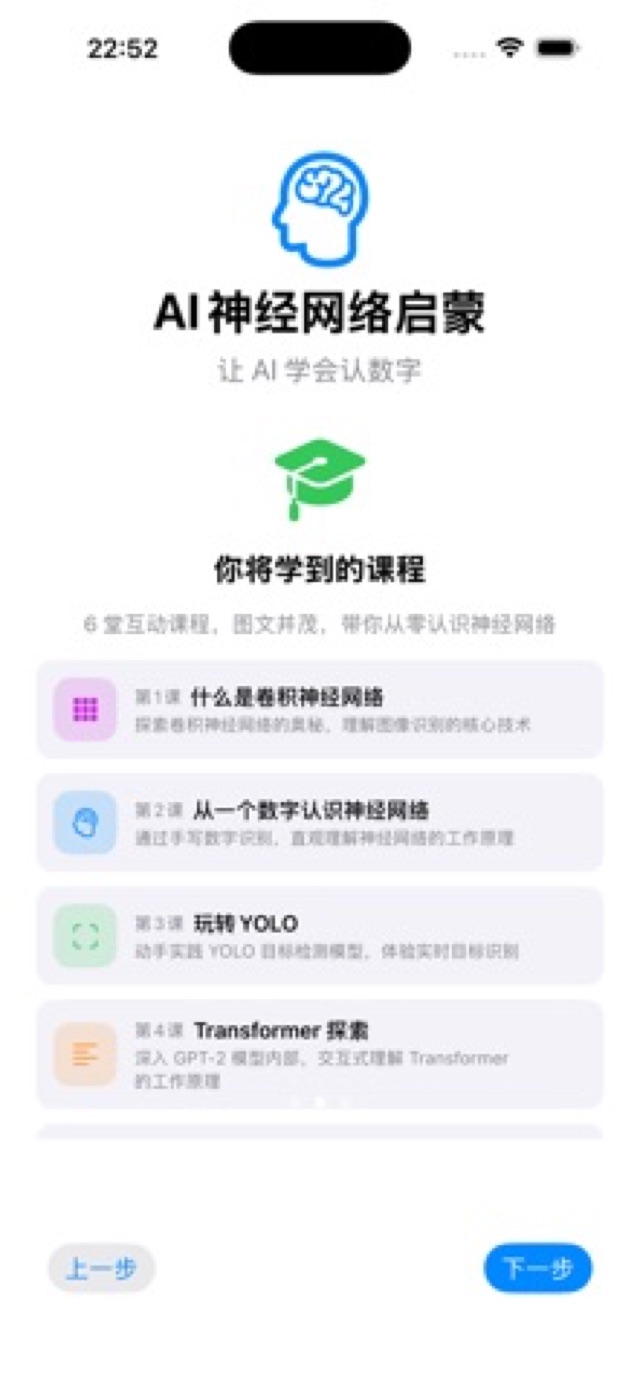
Sechs interaktive Kurse führen von der Ziffernerkennung bis zu multimodalen LLMs — angetrieben von einer selbstgebauten Tensor-Engine, die direkt auf dem Gerät wirklich trainiert und rechnet, mit Visualisierungen auf Matrixebene, die jeden Schritt sichtbar machen.
- 6 interaktive Kurse
- Tensor-Engine auf dem Gerät
- Visualisierung auf Matrixebene
- Erste 3 Kurse gratis
Was es kann
Keine Formelwände: Dreh selbst an den Reglern und sieh den Matrizen beim Fließen zu — vom „schon mal gehört“ zum echten Verstehen.
Interaktive Kurse
MNIST → CNN → YOLO → Transformer → MoE → multimodal: sechs Kurse, Schritt für Schritt.
KI-Engine auf dem Gerät
Eine selbstgebaute Tensor-Engine, beschleunigt durch Accelerate, mit automatischer Differenzierung fürs Backprop — alles auf deinem Gerät.
Matrix-Visualisierungen
QKV, Attention und Heatmaps der Gewichte entfalten sich Ebene für Ebene — abstrakte Mathematik wird zu sichtbaren Punkten.
Praxiserlebnis
Eine YOLO-Kamera erkennt Objekte um dich herum in Echtzeit — lern es und spiel damit.
Interaktive Kurse
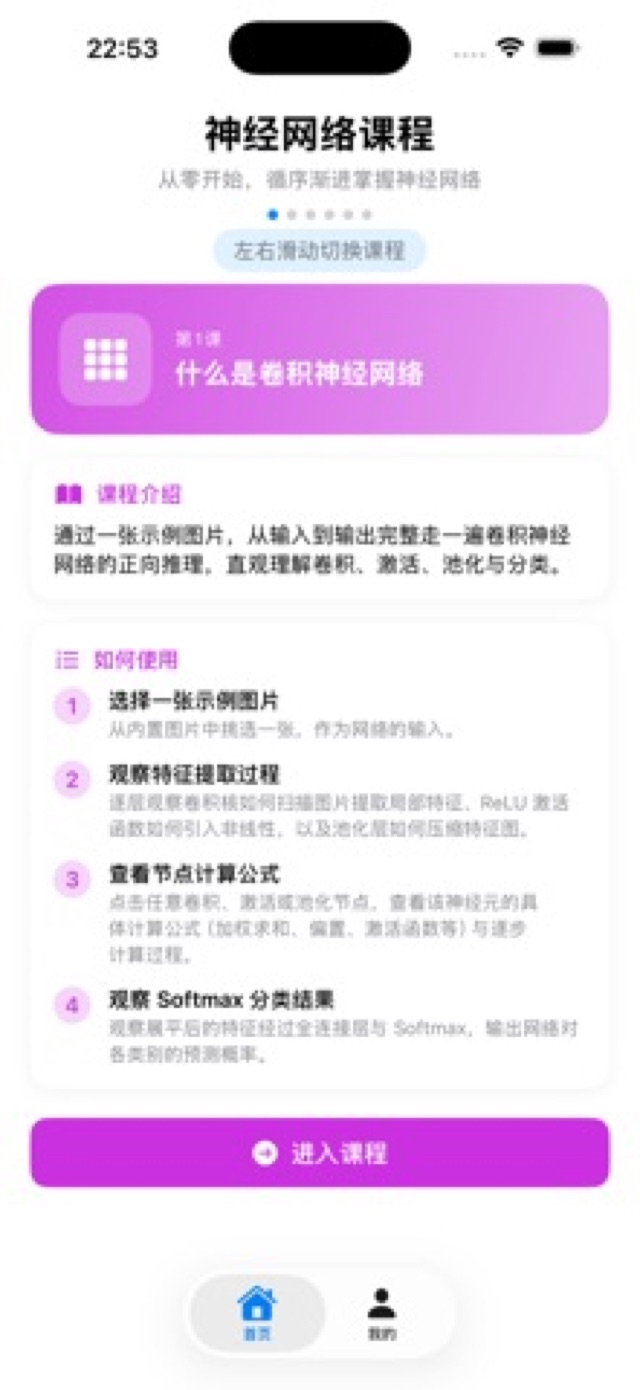
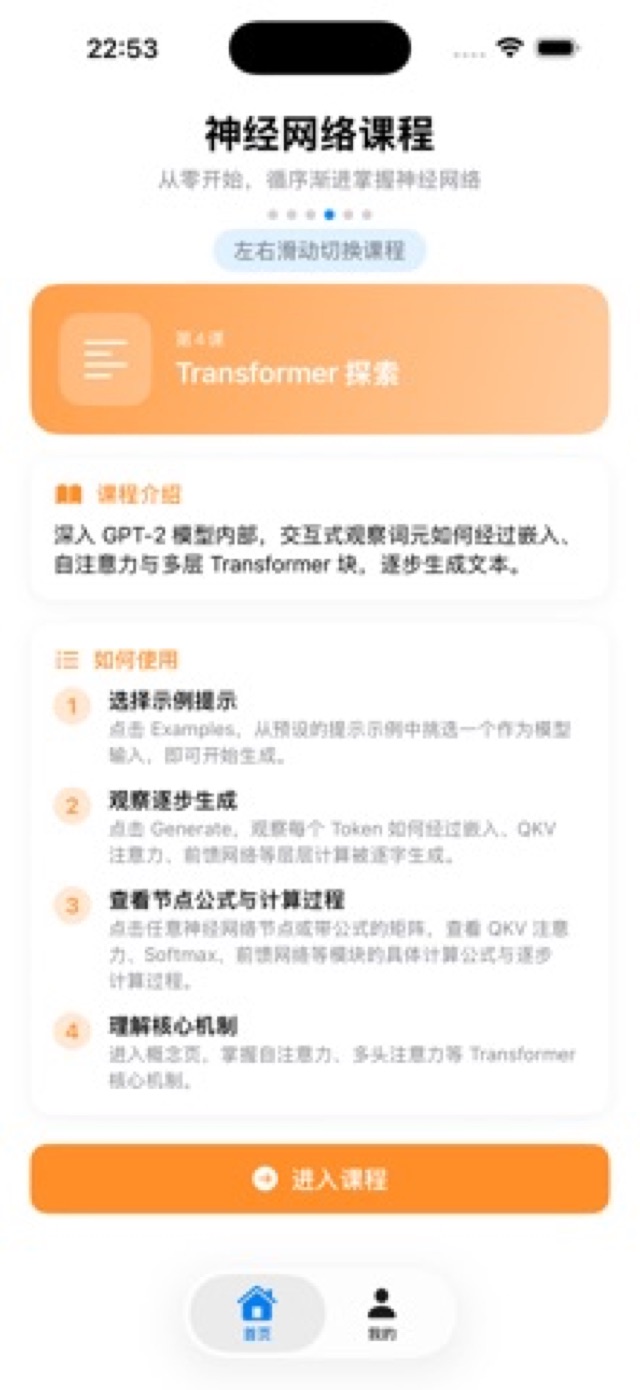
Jeder Kurs zerfällt in kleine Level: erst Konzeptkarten in klaren Worten, dann selbst schrauben mit sofortigem Feedback.
Sechs Kurse, aufsteigend
Starte mit MNIST-Ziffernerkennung, gehe über CNN, YOLO und Transformer bis hin zu MoE und multimodalen LLMs.
Gamifizierte Level
Jeder Kurs ist eine Kette kleiner Level — Übung abschließen, nächstes Level frei, mit echtem Vorwärtsdrang.
Metaphern-Karten
Gewichte als Mischpult-Fader, Attention als Spotlight — erst die Intuition, dann die Mathematik.
Die Engine auf dem Gerät
Das ist keine vorab aufgenommene Animation — Training und Inferenz laufen auf deinem Gerät, und die Parameteränderungen sind echt.
Eine selbstgebaute Tensor-Engine
Matrixoperationen laufen beschleunigt über Apples Accelerate-Framework (cblas_sgemm) — klein, aber schnell.
Automatische Differentiation
Backprop übernimmt die automatische Differentiation — der Vorwärtsdurchlauf bestimmt den Gradienten, und der Code ist das Lehrbuch.
Kein Netz nötig
Alle Kurse und Modelle laufen lokal — im Flugmodus lernt es sich genauso gut.
Matrix-Visualisierungen
Die „Blackbox“ entfaltet sich zu sichtbaren Matrixflüssen — sieh genau, wohin die Attention blickt.
QKV, Schritt für Schritt
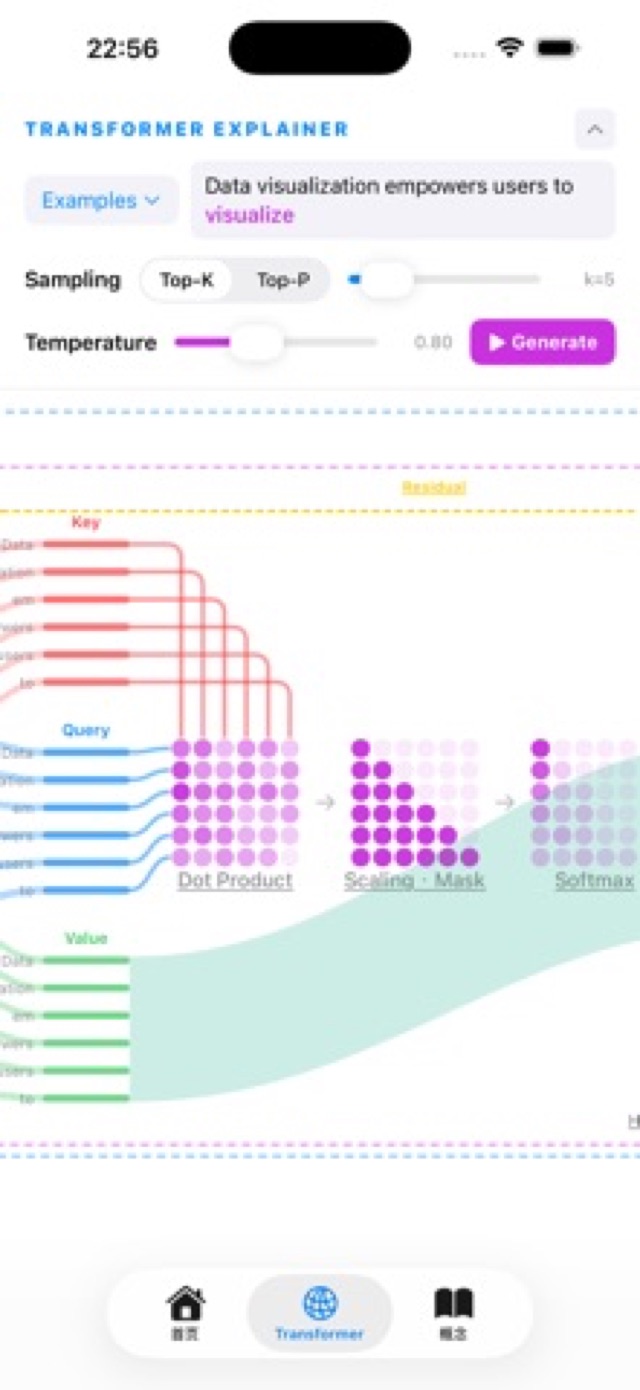
Sieh zu, wie Query-, Key- und Value-Matrizen multipliziert, skaliert und zu Attention normalisiert werden — animiert, Schritt für Schritt.
Attention-Punkte
Attention-Gewichte erscheinen als Punktgitter-Heatmaps — sofort erkennbar, welchem Token das Modell Aufmerksamkeit schenkt.
Heatmaps der Gewichte
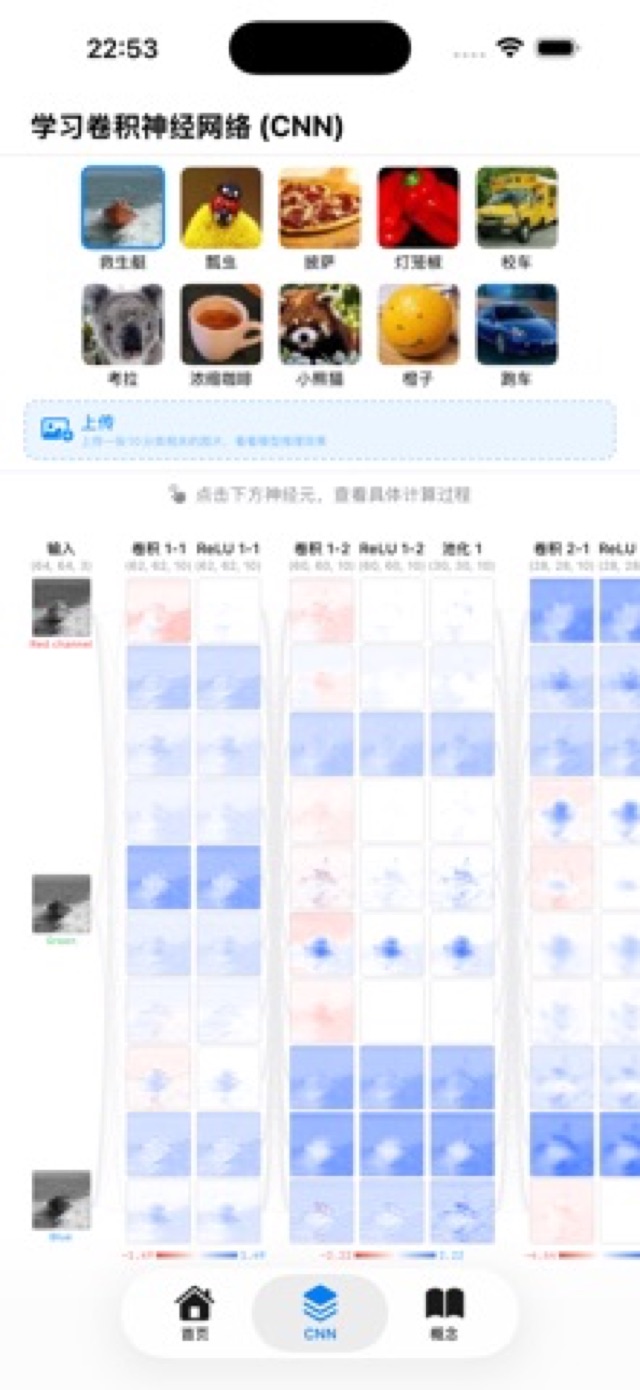
Beobachte die Gewichte live beim Training — und sieh dem Netz beim Lernen förmlich zu.
Galerie
Von interaktiven Levels bis zu Matrix-Ansichten — ein Blick in die echte App.
Häufige Fragen
Was kostet die App?
Die ersten 3 Kurse sind komplett kostenlos; ein einmaliger VIP-Kauf schaltet alle 6 Kurse plus künftige Updates frei — ohne Abo.
Brauche ich Mathe- oder Programmierkenntnisse?
Überhaupt nicht. Die Kurse setzen null Vorkenntnisse voraus und nutzen Metaphern und Visualisierungen statt Herleitungen — beim Anfassen kommt das Verstehen von allein.
Wo laufen die Modelle? Brauche ich Internet?
Alles läuft auf deinem Gerät. Die App bringt ihre eigene Tensor-Engine mit — Training und Inferenz verlassen das Telefon nie, und alle Kurse funktionieren offline.
Welche Geräte werden unterstützt?
iPhone und iPad, erfordert iOS 17 oder neuer.
Trainiere heute dein erstes neuronales Netz
Abstrakte KI beginnt mit deiner ersten sichtbaren Matrix.